类型化世界状态
列式表是唯一的真相源。agent、模块与提供者读取视图并产出效果;由一个解析器统一应用。
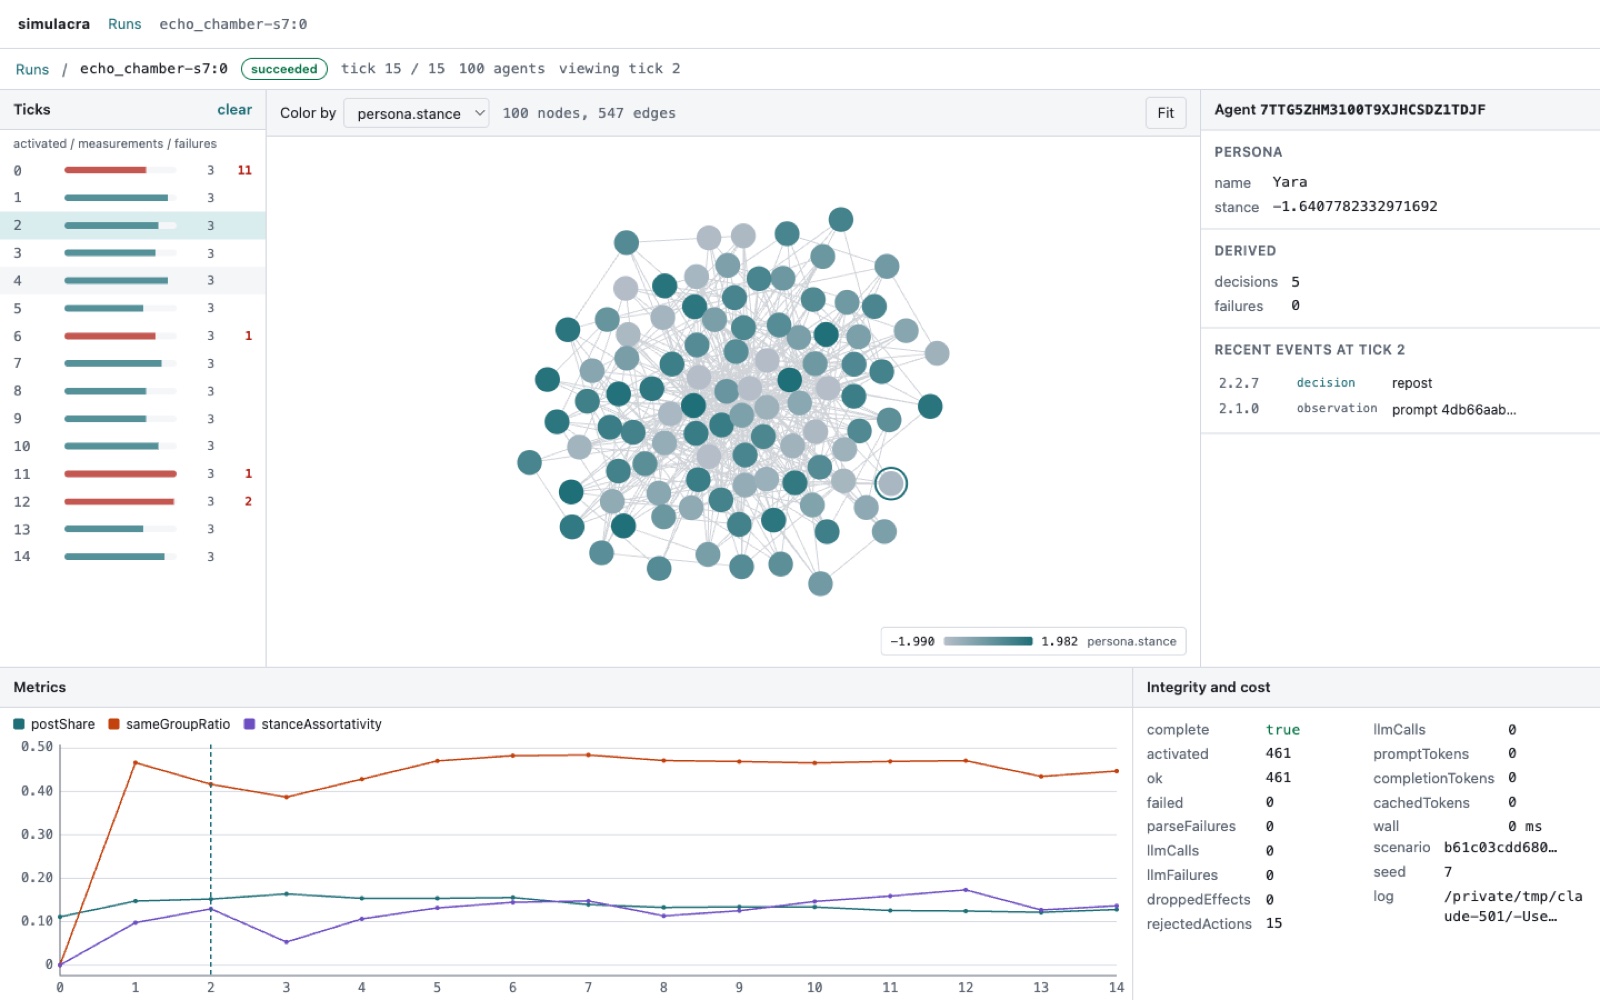
用确定性的 mock 提供者运行回音室示例:
bun run simulacra run examples/echo_chamber/scenario.yaml --seed 7 --provider mock --out runs/echo在人格格式、措辞框架与记忆表示三个方向上审计囚徒困境示例:
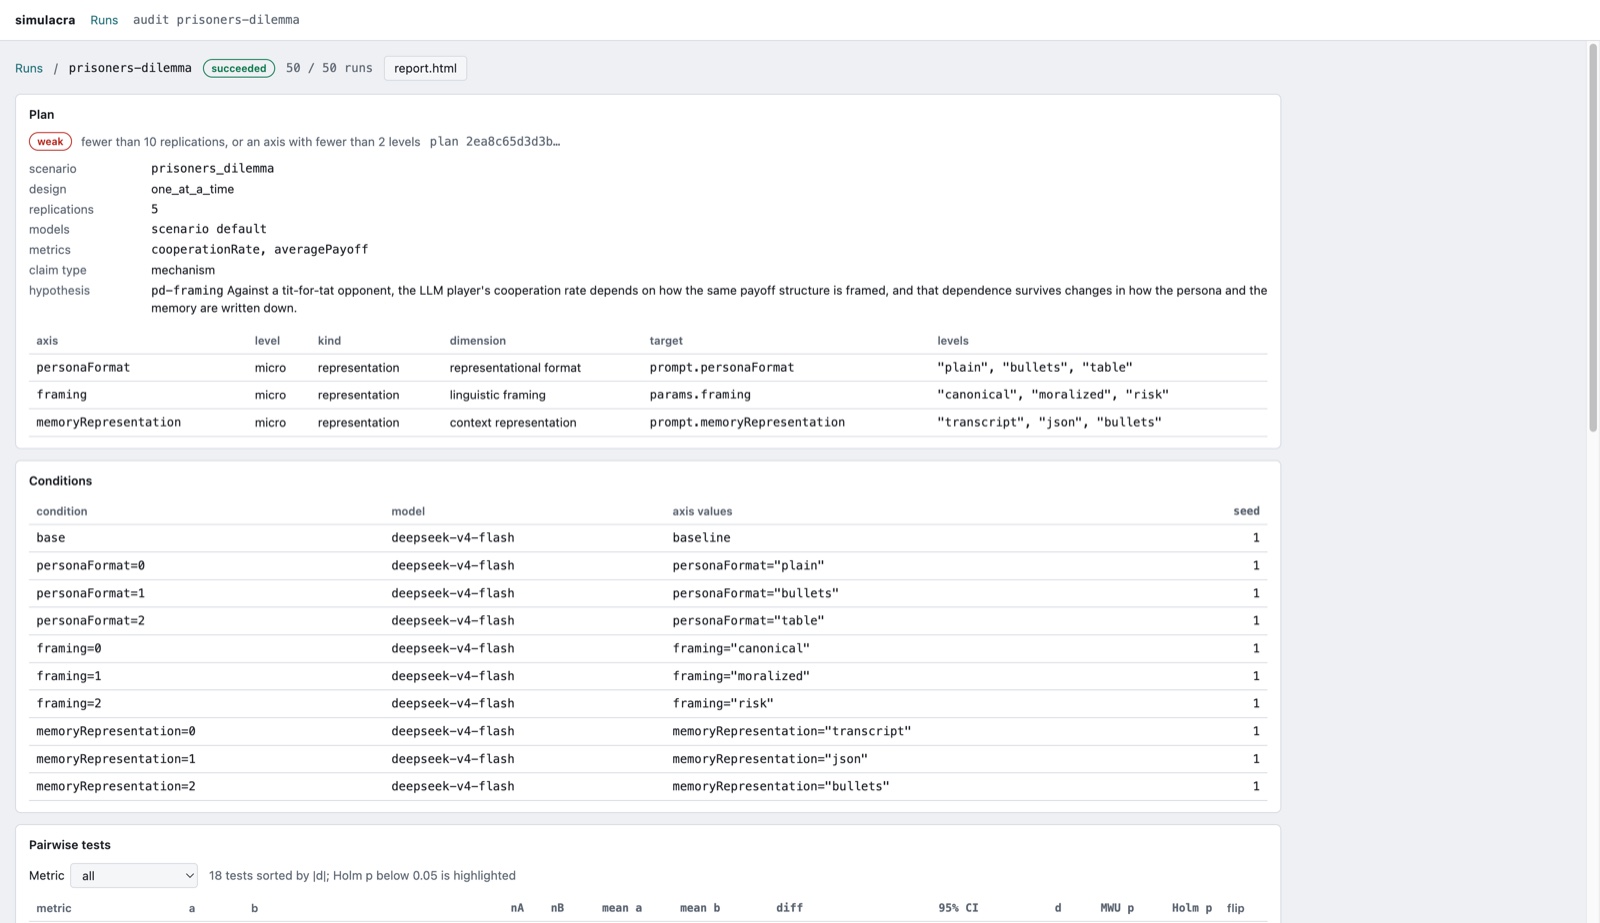
bun run simulacra audit examples/prisoners_dilemma/audit.yaml --replications 5 --provider mock --out audits/pd打开 GUI 查看刚刚产出的运行与审计:
bun run simulacra serve --data .换成真实模型:设好 SIMULACRA_LLM_API_KEY,去掉 --provider mock。任何 OpenAI 兼容端点都可以。默认是 DeepSeek,预设里关掉了思考,好让结构化回答装进不大的 token 预算;mlx-lm 与 LM Studio 的预设也只差一个参数。先跑一次 bun run simulacra doctor --llm,确认端点支持结构化输出、并发与缓存 token 上报。
两个示例都自带对 deepseek-v4-flash 的录制。加 --llm-mode replay 可以离线对着这些录制跑,加 --llm-mode record 则录制自己的。
bun test耗时来自基准,在 Apple M5 Max 与 Bun 1.3.11 上测得。
运行视图:带失败计数的 tick 时间线、按立场着色的网络、单个 agent 从观察到效果的因果链、指标序列、完整性与开销。
审计视图:计划与证据等级、扰动轴、条件、带 Holm 校正 p 值的成对检验、敏感度排序与方向一致性。